Engenharia de Dados
Seu ERP tem os dados. Então por que sua empresa ainda depende de planilhas?
Ter os dados dentro do ERP não significa ter uma estrutura preparada para análise. Entenda como a Engenharia de Dados transforma informações operacionais em uma base confiável para BI, sistemas, automações e IA.
O ERP foi feito para operar. Não necessariamente para analisar.
Pedidos, clientes, produtos, estoque, faturamento, produção e movimentações financeiras. Grande parte dos dados importantes de uma empresa já está dentro do ERP.
Mesmo assim, é comum encontrar empresas exportando relatórios para Excel, cruzando planilhas manualmente e esperando horas para obter uma informação que deveria estar disponível em segundos.
O problema, muitas vezes, não é a falta de dados. É a forma como esses dados estão disponíveis.
Um ERP precisa registrar pedidos, movimentar estoque, emitir documentos e sustentar a operação da empresa. Essas são suas prioridades.
Quando começamos a exigir dele análises históricas complexas, cruzamentos entre grandes volumes de informação e consultas executivas, estamos tentando transformar um sistema operacional em uma plataforma analítica. E são problemas diferentes.
O problema começa quando tudo depende do ERP
Imagine uma empresa que possui informações de estoque, vendas, clientes, produtos, produção, e-commerce, preços e movimentações entre lojas.
Agora imagine dashboards, aplicações, relatórios e integrações consultando diretamente as tabelas do ERP. A arquitetura começa a ficar assim:
- ERP → Dashboard
- ERP → Aplicação
- ERP → E-commerce
- ERP → Relatório
- ERP → Integração
- ERP → Automação
Funciona no começo. Com o crescimento da operação, porém, cada novo sistema cria outra dependência sobre o banco operacional. Além disso, cada aplicação pode interpretar a mesma informação de maneira diferente.
É aí que a Engenharia de Dados começa a fazer diferença.
Criando uma camada de dados entre o ERP e o negócio
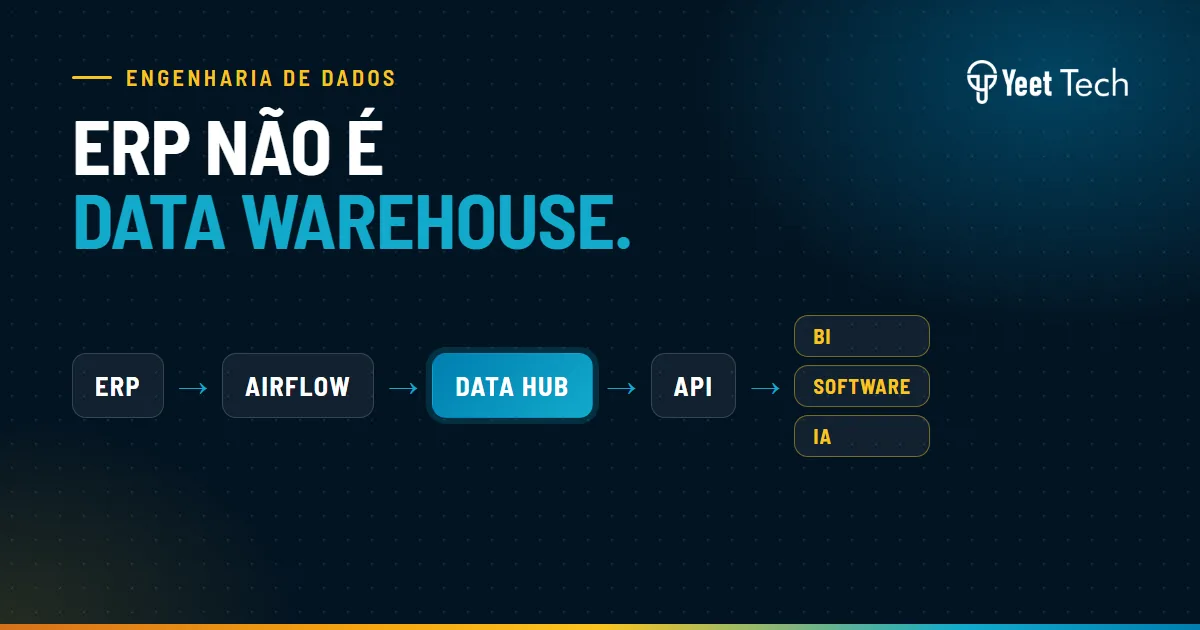
Uma arquitetura mais estruturada pode funcionar assim:
ERP / Firebird
      ↓
Apache Airflow
      ↓
PostgreSQL / Data Hub
      ↓
RAW → Bronze → Silver → Gold
      ↓
APIs / BI / Aplicações / Automação / IA
Nesse modelo, o ERP continua fazendo aquilo para o qual foi criado: operar o negócio. A plataforma de dados passa a assumir outra responsabilidade: organizar e disponibilizar informação.
O papel do Apache Airflow
Não queremos alguém exportando um CSV toda manhã. Precisamos de processos capazes de executar automaticamente. É aqui que entram os pipelines de dados.
O Apache Airflow pode orquestrar processos como:
Extrair → Validar → Transformar → Carregar → Monitorar
Por exemplo: às 05:00 um pipeline consulta as informações de estoque no ERP. Depois, outro processo trata e padroniza esses dados. Em seguida, as informações são carregadas no ambiente analítico.
Quando a equipe começa o expediente, os dados necessários para suas análises já estão disponíveis. E o mesmo princípio vale para vendas, clientes, produtos, preços, produção e outras áreas.
RAW, Bronze, Silver e Gold: por que tantas camadas?
Separar os dados em camadas ajuda a definir responsabilidades.
RAW
É a informação mais próxima possível da origem. O objetivo é preservar aquilo que foi recebido do sistema fonte (ERP → RAW).
Bronze
Começamos a estruturar e organizar os dados ingeridos: tipos, campos, duplicidades e outras características necessárias ao processamento (RAW → Bronze).
Silver
Os dados passam por tratamentos e regras que permitem combiná-los de forma mais consistente. É onde diferentes fontes começam a formar uma visão integrada (Bronze → Silver).
Gold
É a camada mais próxima do consumo pelo negócio. Aqui ficam informações preparadas especificamente para estoque, comercial, produção, clientes, financeiro e e-commerce.
E então: Gold → Dashboard / API / Sistema / IA.
Um exemplo: estoque
Considere uma empresa com várias lojas. Perguntar simplesmente "quanto tenho em estoque?" pode não ser tão simples quanto parece. Podemos precisar considerar:
- estabelecimento e localização;
- modelo, produto, cor e tamanho;
- saldo físico, quantidade alocada e disponibilidade;
- movimentações, preço e vendas recentes.
Se cada relatório reconstruir essas regras individualmente, diferentes sistemas podem chegar a números diferentes.
A Engenharia de Dados permite centralizar essas regras e disponibilizar uma informação consistente para os diferentes consumidores. O dashboard deixa de precisar descobrir como calcular o estoque: ele recebe uma informação preparada para análise.
E onde entram o Spring Boot e o Angular?
Depois que os dados estão organizados, podemos ir além do BI.
Imagine que o PostgreSQL possui uma visão preparada do estoque. Uma API desenvolvida em Spring Boot pode disponibilizar GET /api/estoques, e o Angular consome essa API e apresenta a informação em uma aplicação:
Firebird (ERP)
      ↓
Apache Airflow
      ↓
PostgreSQL
      ↓
Spring Boot / REST API
      ↓
Angular
      ↓
Usuário
O frontend não precisa conhecer a estrutura interna do ERP. E o ERP não precisa ser exposto diretamente para cada nova aplicação.
E a Inteligência Artificial?
Antes de pensar em IA, precisamos pensar nos dados que ela poderá utilizar.
Se vendas, estoque, clientes e produtos possuem definições diferentes espalhadas por planilhas e sistemas, conectar uma IA não resolve automaticamente o problema. Ela continuará dependendo da qualidade da informação disponível.
Com uma plataforma de dados estruturada, começamos a criar outro cenário:
ERP + E-commerce + Sistemas
      ↓
Engenharia de Dados
      ↓
Dados estruturados
      ↓
APIs
      ↓
IA
Então perguntas como estas podem, no futuro, ser respondidas por agentes que utilizam dados reais e regras controladas da empresa:
Quais produtos estão com excesso de estoque?
Quais lojas precisam de abastecimento?
Por isso, IA não começa no chatbot. Começa no dado.
Engenharia de Dados não é apenas mover informações
Copiar uma tabela de um banco para outro é relativamente simples. O verdadeiro trabalho está em garantir que os dados sejam confiáveis, rastreáveis, atualizados, padronizados e úteis.
A tecnologia é apenas parte do problema. Também precisamos entender o significado da informação dentro da operação. Um campo chamado SALDO pode significar uma coisa para o banco de dados e outra completamente diferente para quem precisa decidir se determinado produto deve ser enviado para uma loja.
Do dado ao resultado
Uma arquitetura moderna de dados transforma o ERP em informação estruturada, que pode alimentar dashboards, aplicações, integrações, automações e inteligência artificial.
O objetivo final não é possuir mais tecnologia. É diminuir a distância entre o que está acontecendo na operação e quem precisa tomar uma decisão.
Yeet Tech
Na Yeet Tech, trabalhamos justamente nessa camada entre sistemas, dados e decisão:
ERP → Integração → Engenharia de Dados → API → Software → BI → IA
Não começamos pelo dashboard. Começamos pelo dado.
Yeet Tech — Decifrando dados. Impulsionando resultados.